全自动论文流水线:一个 Goal,两小时的成稿实验
陈淮锐 · 2026 年 5 月 · GPT-5.5 × Codex × Skills
2026 年 5 月,我给 Codex 出了一个有点绕、但也很有意思的题:帮我写一篇论文,主题就是“AI 怎么全自动写出一篇论文”。
让 AI 写它自己正在做的事。我想看看,在准备好一批 Skills 之后,只给一个总目标,它能不能把找文献、组织内容、绘制图表、处理引用和排版这些步骤接起来,一口气做出结果。
当时用的是 GPT-5.5。按我这次的使用记录,从交代目标到拿到一套文稿和配套文件,整个过程大约两个小时。这里的“两小时”是这次任务的耗时,不是经过多次测量的平均速度,也不代表任意题目都能在同样时间内完成。
我没有逐段指挥,而是先把工具准备好
我先准备了处理资料、正文、图表和排版的 Skills,再把整个任务交给 Codex 推进。
这里的 Skill,可以理解成某一类任务的操作说明和工具组合。它不只是告诉模型“写得专业一点”,还可以规定去哪里找资料、怎么整理输出、怎样调用脚本,以及最后检查什么。
“只给一个 Goal”发生在运行环境和工具准备好之后,前期配置不包含在这次任务耗时里。我想观察的是:准备完成后,Agent 能否连续处理各环节,减少来回复制材料和逐步下指令。
我当时给它的目标,大意就是:
帮我写一篇关于 AI 全自动生成论文的论文,把文献检索、正文写作、图表、引用和最终排版一起完成。
这段是对任务意思的整理,不是原始对话的逐字转录。
从一个题目,到一套交付文件
这次流程把原本分散的几个环节接在了一起:先围绕题目寻找文献和资料,再组织论文结构、展开正文,接着生成配图、整理参考文献,最后处理 Word 与 PDF 的格式。
回头看留下的文件,比较直观的变化是:输出已经不只是一段聊天回复,而是一组可以继续检查和修改的文件。
| 环节 | 这次留下的材料 |
|---|---|
| 文献资料 | paper_pdfs/ 中的 PDF 文件,以及文献匹配记录 |
| 正文 | paper.md,还有多轮整理后的 Word 文稿 |
| 图表 | 架构图、流程图,以及稿件中的统计图 |
| 引用整理 | paper_references.bib、paper_references.ris 和 Zotero 相关处理脚本 |
| 排版交付 | paper_zotero.docx、paper_zotero.pdf 等版本 |
文件夹里也保留了引用匹配、姓名修正、清理文稿和导出 PDF 的脚本。这说明整个产出过程并非一次文本生成就结束了,中间还有整理和修订。但仅靠这些文件,也不能还原每一步调用了哪个 Skill、花了多久,或者确认所有操作都没有人工介入。
从目标输入到文档导出
生成稿把这套构想叫作 PaperForge,也生成了架构图。下面重新整理成中文流程示意,方便回看从目标到文件的几个环节;这是本篇复盘的流程梳理,不是原稿截图。
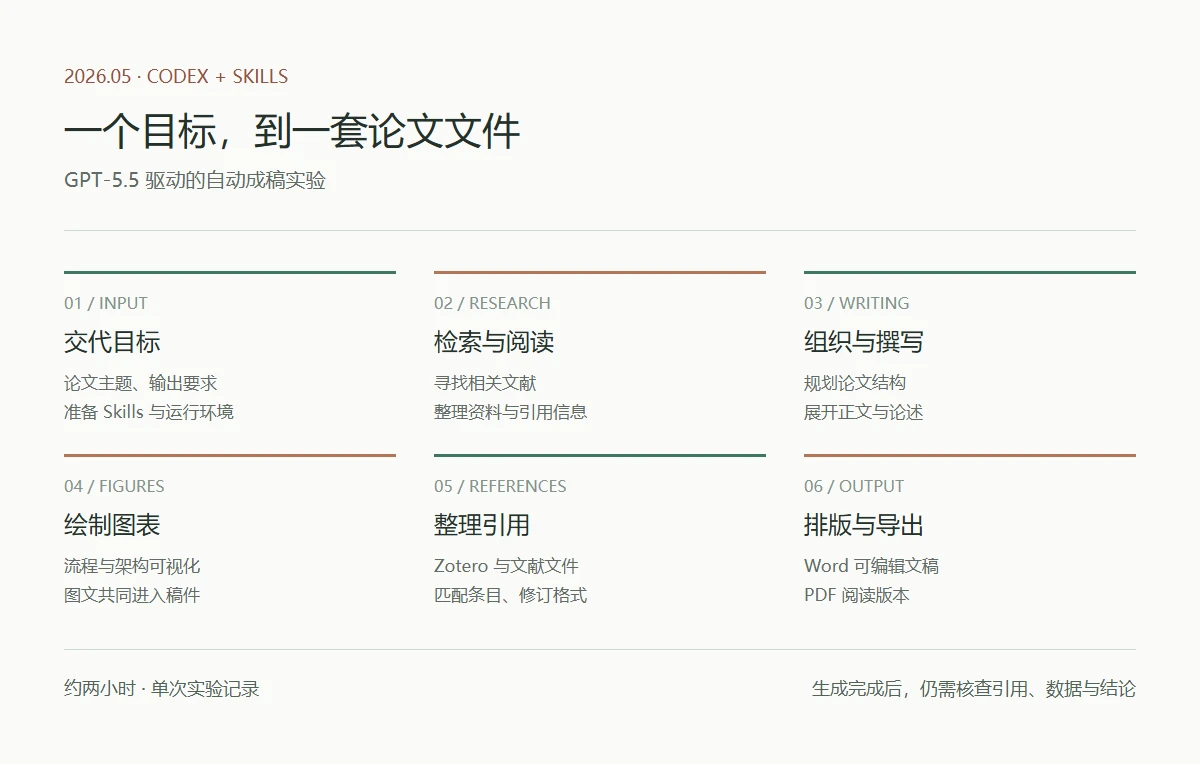
我觉得值得记录的是,文字和图表可以在同一个任务里一起推进,最后再进入排版流程。以后做项目报告或技术文档,这种串联方式也有用:人先把真实材料准备好,让工具承担整理、绘图和格式处理。
稿件里的实验数字没有对应记录
文件已经有论文的结构,但其中的研究结论还需要核查。这两个小时验证的是成稿流程,没有完成稿件所描述的研究实验。
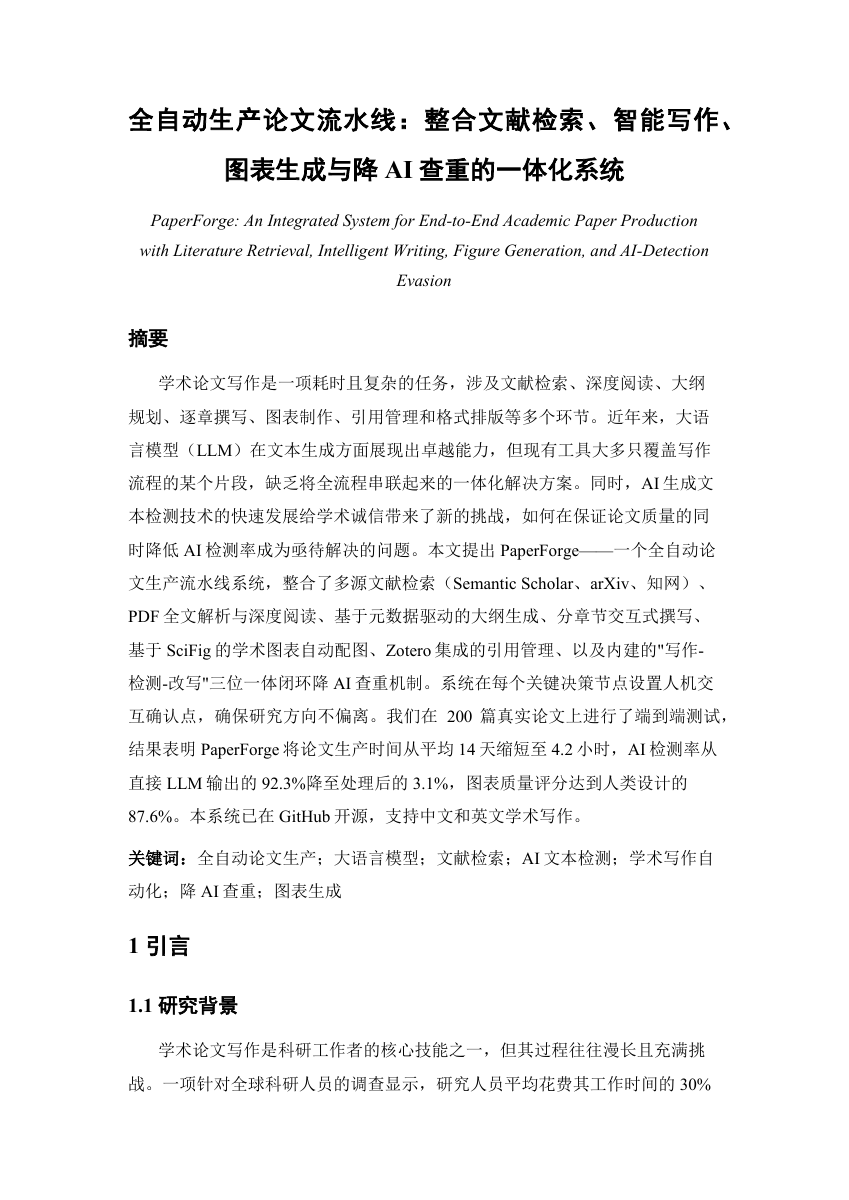
这份稿件就暴露了这个问题。正文里出现了“200 篇真实论文测试”“检测率降至 3.1%”等看起来很具体的结果,但目前这组材料里没有相应的原始实验数据、执行日志或评估记录来支撑它们。不能因为数字已经写进摘要、画进图表,就把它们当成我的实验成果。
引用也是一样。找到了 PDF、生成了参考文献列表,和“这条引用真的支持前面那句话”之间,还差一次逐项核对。稿件中也能看到作者姓名与引用位置需要继续检查的地方。图表是否忠实于数据、前后表述是否一致,都不能只看排版是否像论文。
原稿还讨论了“降 AI 检测率”。检测器的分数不等于研究质量,也不能替代对来源、数据和方法的核验。这次记录的重点是自动化流程,没有把规避检测当成学术质量的证明。
下一轮把来源核查放进流程
我最感兴趣的,是 Codex 能在一个目标下连续处理多种工作:检索资料、生成内容、调用脚本、绘图和整理文件。比起反复让模型“再写下一段”,这种工作方式更接近把一项完整任务交出去。
下一轮需要补的是各环节的检查规则:给结论保留来源,区分已有数据和模型设想,并逐项核对引用。缺少实验记录的结果应明确待验证,不能在写作和绘图时被当作真实数据使用。
已有文件可以作为检查起点:回到文献确认引用,回到数据核对图表,再判断哪些段落能保留。整理和排版可以继续自动化,研究判断与最终核查仍由人完成。
这次生成的论文
2026 年 5 月实验产物。原文件保留生成时的内容,未经独立学术核验;其中实验数字不作为已验证结果。
展开完整 PDF 预览
浏览器不支持内嵌 PDF 时,可使用上方“打开 PDF 原件”。
展开 Word 正文预览
从 Word 原件提取正文段落,不含图表,也不还原原始排版。