电子女友:先让鲸鱼娘开口,再给她一个身体
陈淮锐 · 2026 年 9 月 18 日 · 对话 MVP 已完成,实体接入计划中
2026 年 9 月 22 日更新:Atom-S 上位机功能验证后,已决定退货,原定实体接入计划暂停。下一平台正在评估 ToddlerBot,等待实验室经费。下文保留当时的构想,最新决定见 Atom-S Day 1。
项目名暂时就叫“电子女友”了,有点直白,但确实是我想做的东西:先能跟她说话,再慢慢给她一个能感知、能行动的身体。至于能走到哪一步,得一项一项试。
写这篇时,电脑端和小智对话的 MVP 已经跑通,还没有接入实体机器人。当时打算接 Atom-S,再按实际机构做鲸鱼娘的 3D 打印外壳;下文是 Atom-S 具身机器人项目的前置记录,实体接入计划的后续变化见文首补记。
旧小车缺少哪些反馈
我最初做 Robot Twin AI,想回答的是这个问题:
如果让 AI 参与机器人的研发,它能不能先在真实实验之前,帮助我理解机器人发生了什么、比较几个候选方案,再决定哪个方案值得上车验证?
这个想法没变,麻烦出在继续往下做的时候。命令发过去了,然后呢?车到底动了多少,执行得对不对,总得有反馈才能判断。编码器、执行状态、可对照的数据回传,这些东西绕不过去。
我最初那套 STM32 小车要继续承担这些任务,就得补电机反馈,补采集,补通信,再验证补上去的东西。越往下看,改造成本越高。这里说的是我手里这套小车的配置,别误会成 STM32 做不了;能做,只是我还要不要继续往里面投时间和硬件。
最后决定先停下来,把后续投入转向另一台机器人。Robot Twin AI 目前基本停止维护,代码和阶段记录保留。 前面那些实验也没白做,至少让我知道哪些反馈必须有,哪些结果还不能信。新平台的选型也会据此检查反馈接口和可验证的范围。
换平台以后,反馈精度、延迟、同步和 sim2real 仍需重新验证。已有经验能帮助安排检查,不能代替新硬件的结果。
当时为什么选 Atom-S
按目前的选型资料和我的了解,Atom-S 提供 10 个自由度的舵机、磁编码器反馈,并支持树莓派及后续硬件扩展。这些是我选择它的主要原因:希望在已有的身体和扩展基础上,逐步连接感知、对话与动作。
资料看起来合适,真正接上是什么情况,还得确认硬件版本、开放接口、能读哪些量、多久更新一次。写着“有编码器”当然是好事,但我能不能稳定读出来、时间能不能对上,又是下一件事了。
现阶段,先验证单关节控制和反馈,再考虑多关节动作、平衡和上层交互。树莓派是否加入、承担什么计算任务,也要等实际需求和算力评估后决定。
先让她在电脑上开口
对话这部分从开源的 xiaozhi-esp32-server 开始,补上电脑端客户端和本地服务编排。现成项目已经做了不少工作,我没有从头训练模型,目前也没有一台接好了这些服务的实体机器人。
项目里的电脑端说明记录了这样一条链路:
- 麦克风采集声音,用 Silero VAD 判断说话片段。
- SenseVoice / FunASR 将语音转成文字。
- Ollama 提供多轮对话回复。
- 语音合成生成回复,再通过本机扬声器或耳机播放。
语音目前围绕 Fish Speech v1.5.1 调试。接口能返回音频,只说明它出声了;声音像不像我想要的,还得自己听。目标音色这一步仍然要人工确认。
这里的“已完成”,指我已经跑通电脑端与小智对话的 MVP。它不包含实体动作、稳定步行、长期记忆或自主行为等尚未验证的能力。
接通了,但聊天怎么还是不顺
本地记录里,真正要调的东西都挺琐碎:模型还在思考,要等多久才回复?语音合成第一次启动怎么这么慢?一句话换口气,VAD 会不会以为我说完了?还有,每一轮真的都要查定位和天气吗?
这些问题落到聊天里就很直接:我还没说完,它抢答了;我已经说完,它又半天没声。光换一个更大的模型不一定管用,得拆开看是识别、生成,还是语音合成在拖时间。
项目中保留了客户端、服务检查、文本与语音测试脚本,以及延迟记录。后面会继续用这些记录比较修改前后的表现,不把一次顺利对话当成长期稳定性的证明。
为什么从一开始就在 Docker 里开发
我考虑过后面把项目迁到别的机器上,所以这次没有把所有服务都直接堆进宿主机,而是在 Docker 环境里开发和联调,用 Compose 组织小智服务、Ollama 和 Fish Speech。目标是把服务怎么启动、模型放哪里、配置怎样接起来这些事留下来,换机器时少靠回忆。
当前配置把模型与缓存放在宿主机目录,再挂载进容器;Fish Speech 的模型目录使用只读挂载,编译缓存单独保存。这样重建容器时不必重新准备所有模型,也能把运行环境和需要保留的数据分开。Fish Speech 使用固定镜像摘要,Ollama 目前仍使用 latest,版本固定还不完整。
这不等于迁移已经验证成功。配置里还有本机的盘符路径、GPU 依赖和外部 Docker 网络,换机器时要逐项调整。现在完成的是本地容器开发与运行环境整理,跨机器迁移和部署复现仍要单独验证。
改了代码,容器里为什么没变化
实际排查中有个很具体的问题:Ollama 适配代码在宿主机上改了,容器里运行的却还是镜像内那一份。项目记录里,最终把需要修改的文件单独挂载进去,重建容器后再检查内容,才确认运行中的代码确实更新了。
对话等待也不是一个原因造成的。项目里分别调整过模型思考输出、Fish Speech 的半精度与编译参数、VAD 的静音判断,以及每轮提示词触发的定位和天气查询。一个是模型生成等待,一个是语音合成,一个是断句,还有一个是额外请求;混在一起看,总会觉得“怎么还是慢”。
因此我保留了 Python 健康检查、文本对话与语音合成验证脚本,以及 JSONL 延迟记录。记录会区分识别完成到首个音频包、首个音频包到结束等阶段。冷启动和热对话不能直接混算,现有少量样本也不足以证明稳定的平均延迟或并发能力。
这些记录把服务是否启动、修改是否生效,以及哪一段等待较长分开了,后续才能针对具体环节调整。
当时拟定的动作接入顺序
当时接 Atom-S 的计划,是让对话层表达意图,再由受限制的动作接口去执行。让大模型想到哪儿就把舵机转到哪儿,显然不行。顺序先这样排:
- 确认身体能被可靠控制。 跑通官方工具,记录关节范围、零位、控制协议和可读取的反馈。
- 建立最小动作接口。 从少量、可停止、有范围限制的动作开始,验证指令与实际动作的一致性。
- 再连接对话意图。 把允许的交互映射到经过验证的动作,保留超时、停止和人工接管机制。
- 逐步扩展。 感知、策略训练和更复杂的行为分别验证,再讨论它们如何协作。
这套计划尚未完成对话到实体动作的闭环,后因硬件选型变化暂停。
至于外壳,概念图还不能直接拿去打印
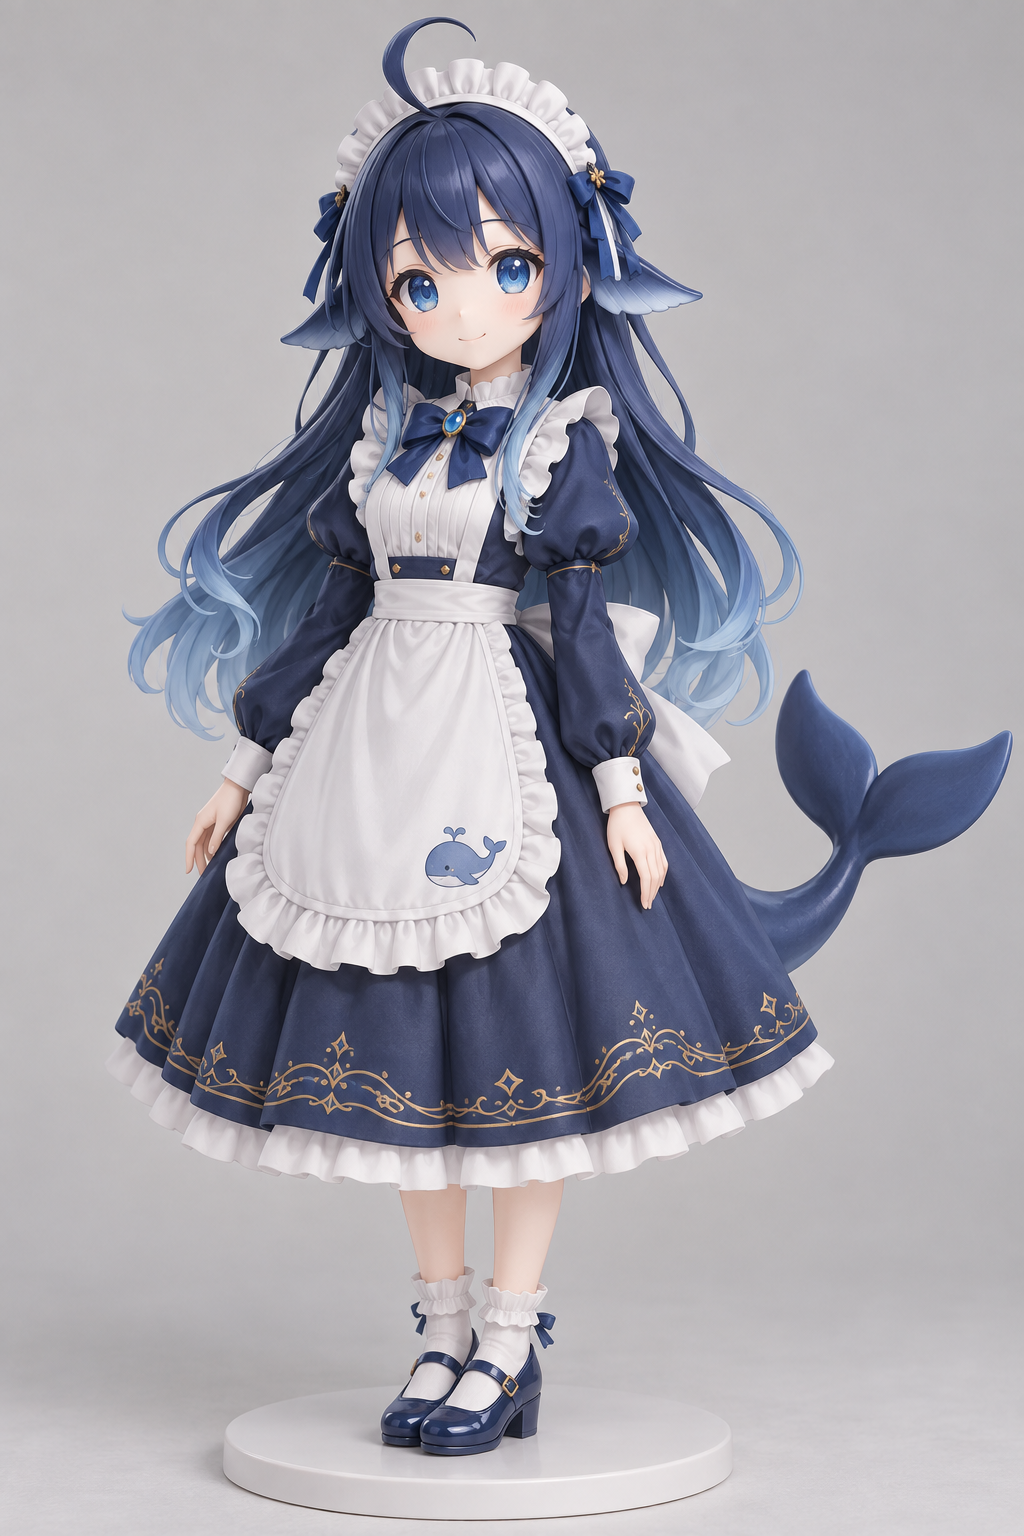
当然,我也不想做完只剩一副裸机构。鲸鱼娘的脸、表情和配色,本来就是我想继续做这个项目的原因之一,所以外壳还是要有的。
目录中已经有外观研究和 Blender 设计文件,但它们仍是概念与结构探索,没有通过完整的壁厚、关节间隙、散热和实际打印装配检查。本文上面的图片展示的是外观目标。
真做外壳,问题就具体了:头发会不会卡关节,裙子会不会挡腿,尾巴会不会把重心拖偏?线从哪里走,电池怎么换,主控怎么散热?这些都得按 Atom-S 的机构重新适配,不能指望一张好看的图替我解决。
因此顺序仍然是:先跑通机器人本体,再做外壳分件、试装和迭代,最后才是完整打印。不会把一张好看的概念图直接当成已经能走路的机械设计。
写作时的项目分工
- Robot Twin AI: 已有实践与复盘,当前基本停止维护,保留它提出的问题和验证方法。
- 电子女友 / 鲸鱼娘: 当前的对话交互前置项目,已完成电脑端小智对话 MVP。
- Atom-S: 后续实体载体,计划承接硬件反馈、动作验证和鲸鱼娘外壳。
这篇记录停在电脑端对话可用、实体未接入、外壳仍在探索的阶段。先把识别、等待和语音播放调顺,再在确定的平台上验证动作接口。